1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
| '''
电商用户评论文本分类
'''
import jieba
import gensim
import scipy
import numpy
import sklearn
from sklearn.tree import DecisionTreeClassifier
from sklearn.naive_bayes import BernoulliNB
stop = ''
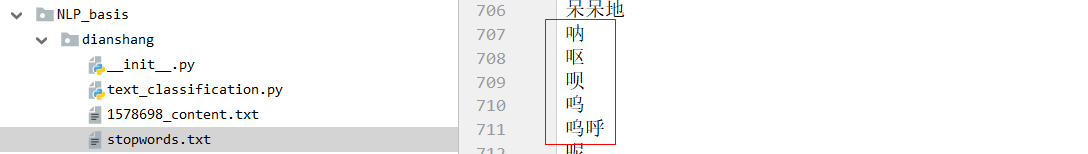
with open('stopwords.txt','r',encoding='gbk',errors='ignore') as s:
for line in s:
line = line.strip()
stop += line
dataList = []
tagList = []
Count = 0
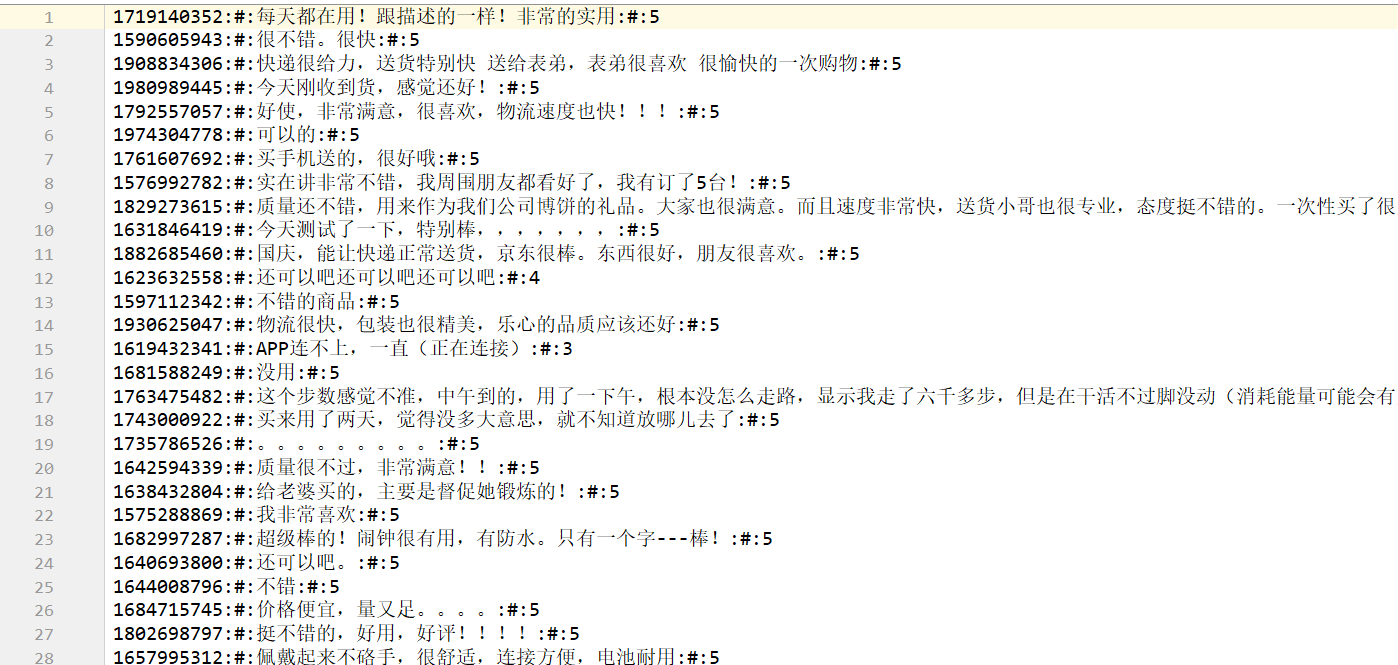
fobjRead =open('1578698_content.txt','r',encoding='utf-8')
for row in fobjRead:
if Count >= 5000:
break
score = int(row[2])
if score >= 4:
flag = 1
elif score >= 3:
flag = 2
else:
flag =3
if flag in [1,3]:
content = row.strip("\n").split(':#:')[1].replace(' ','')
wordList = jieba.cut(content, cut_all=False)
termsAll = list(set([term for term in wordList if term not in stop]))
dataList.append(termsAll)
tagList.append(str(flag))
Count = Count + 1
fobjRead.close()
wordDict = gensim.corpora.Dictionary(dataList)
corpus = [wordDict.doc2bow(doc) for doc in dataList]
data = []
rows = []
cols = []
line_count = 0
for line in corpus:
for elem in line:
rows.append(line_count)
cols.append(elem[0])
data.append(elem[1])
line_count = line_count + 1
matrix = scipy.sparse.csr_matrix((data,(rows,cols))).toarray()
rarray = numpy.random.random(size=line_count)
'''
[[1 1 1 ... 0 0 0]
[0 0 0 ... 0 0 0]
[0 0 0 ... 0 0 0]
...
[0 0 0 ... 0 0 0]
[0 0 0 ... 0 0 0]
[0 0 0 ... 0 0 0]]
[0.26456867 0.31671304 0.24109927 ... 0.68329533 0.81079462 0.91965377]
'''
train_set = []
train_tag = []
test_set = []
test_tag = []
totalCount = sum([500,500])
posCount, negCount = [500,500]
posNow, negNow =0, 0
recordCount = 0
for i in range(line_count):
if rarray[i] < 0.8 and (posNow + negNow) < totalCount:
if tagList[i] == "1" and posNow < posCount:
train_set.append(matrix[i,:])
train_tag.append(tagList[i])
posNow = posNow + 1
elif tagList[i] == "3" and negNow < posCount:
train_set.append(matrix[i,:])
train_tag.append(tagList[i])
negNow = negNow + 1
else:
test_set.append(matrix[i,:])
test_tag.append(tagList[i])
else:
test_set.append(matrix[i,:])
test_tag.append(tagList[i])
del matrix
del rarray
print(train_set)
print(train_tag)
print('--------------------------------------------')
print(test_set)
print(test_tag)
clf = DecisionTreeClassifier()
clf.fit(train_set, train_tag)
clf_predict_test = clf.predict(test_set)
print(sklearn.metrics.classification_report(test_tag,clf_predict_test))
'''
precision recall f1-score support
1 0.74 0.52 0.61 2918
3 0.28 0.50 0.36 1082
accuracy 0.52 4000
macro avg 0.51 0.51 0.48 4000
weighted avg 0.61 0.52 0.54 4000
'''
clf1 = BernoulliNB()
clf1.fit(train_set, train_tag)
clf1_predict_test = clf1.predict(test_set)
print(sklearn.metrics.classification_report(test_tag,clf1_predict_test))
'''
precision recall f1-score support
1 0.74 0.36 0.49 2918
3 0.28 0.65 0.39 1082
accuracy 0.44 4000
macro avg 0.51 0.51 0.44 4000
weighted avg 0.61 0.44 0.46 4000
'''
|